台湾語の長文自動分かち書きを初めて実現、国家レベルの台湾語コーパス検索システムを構築
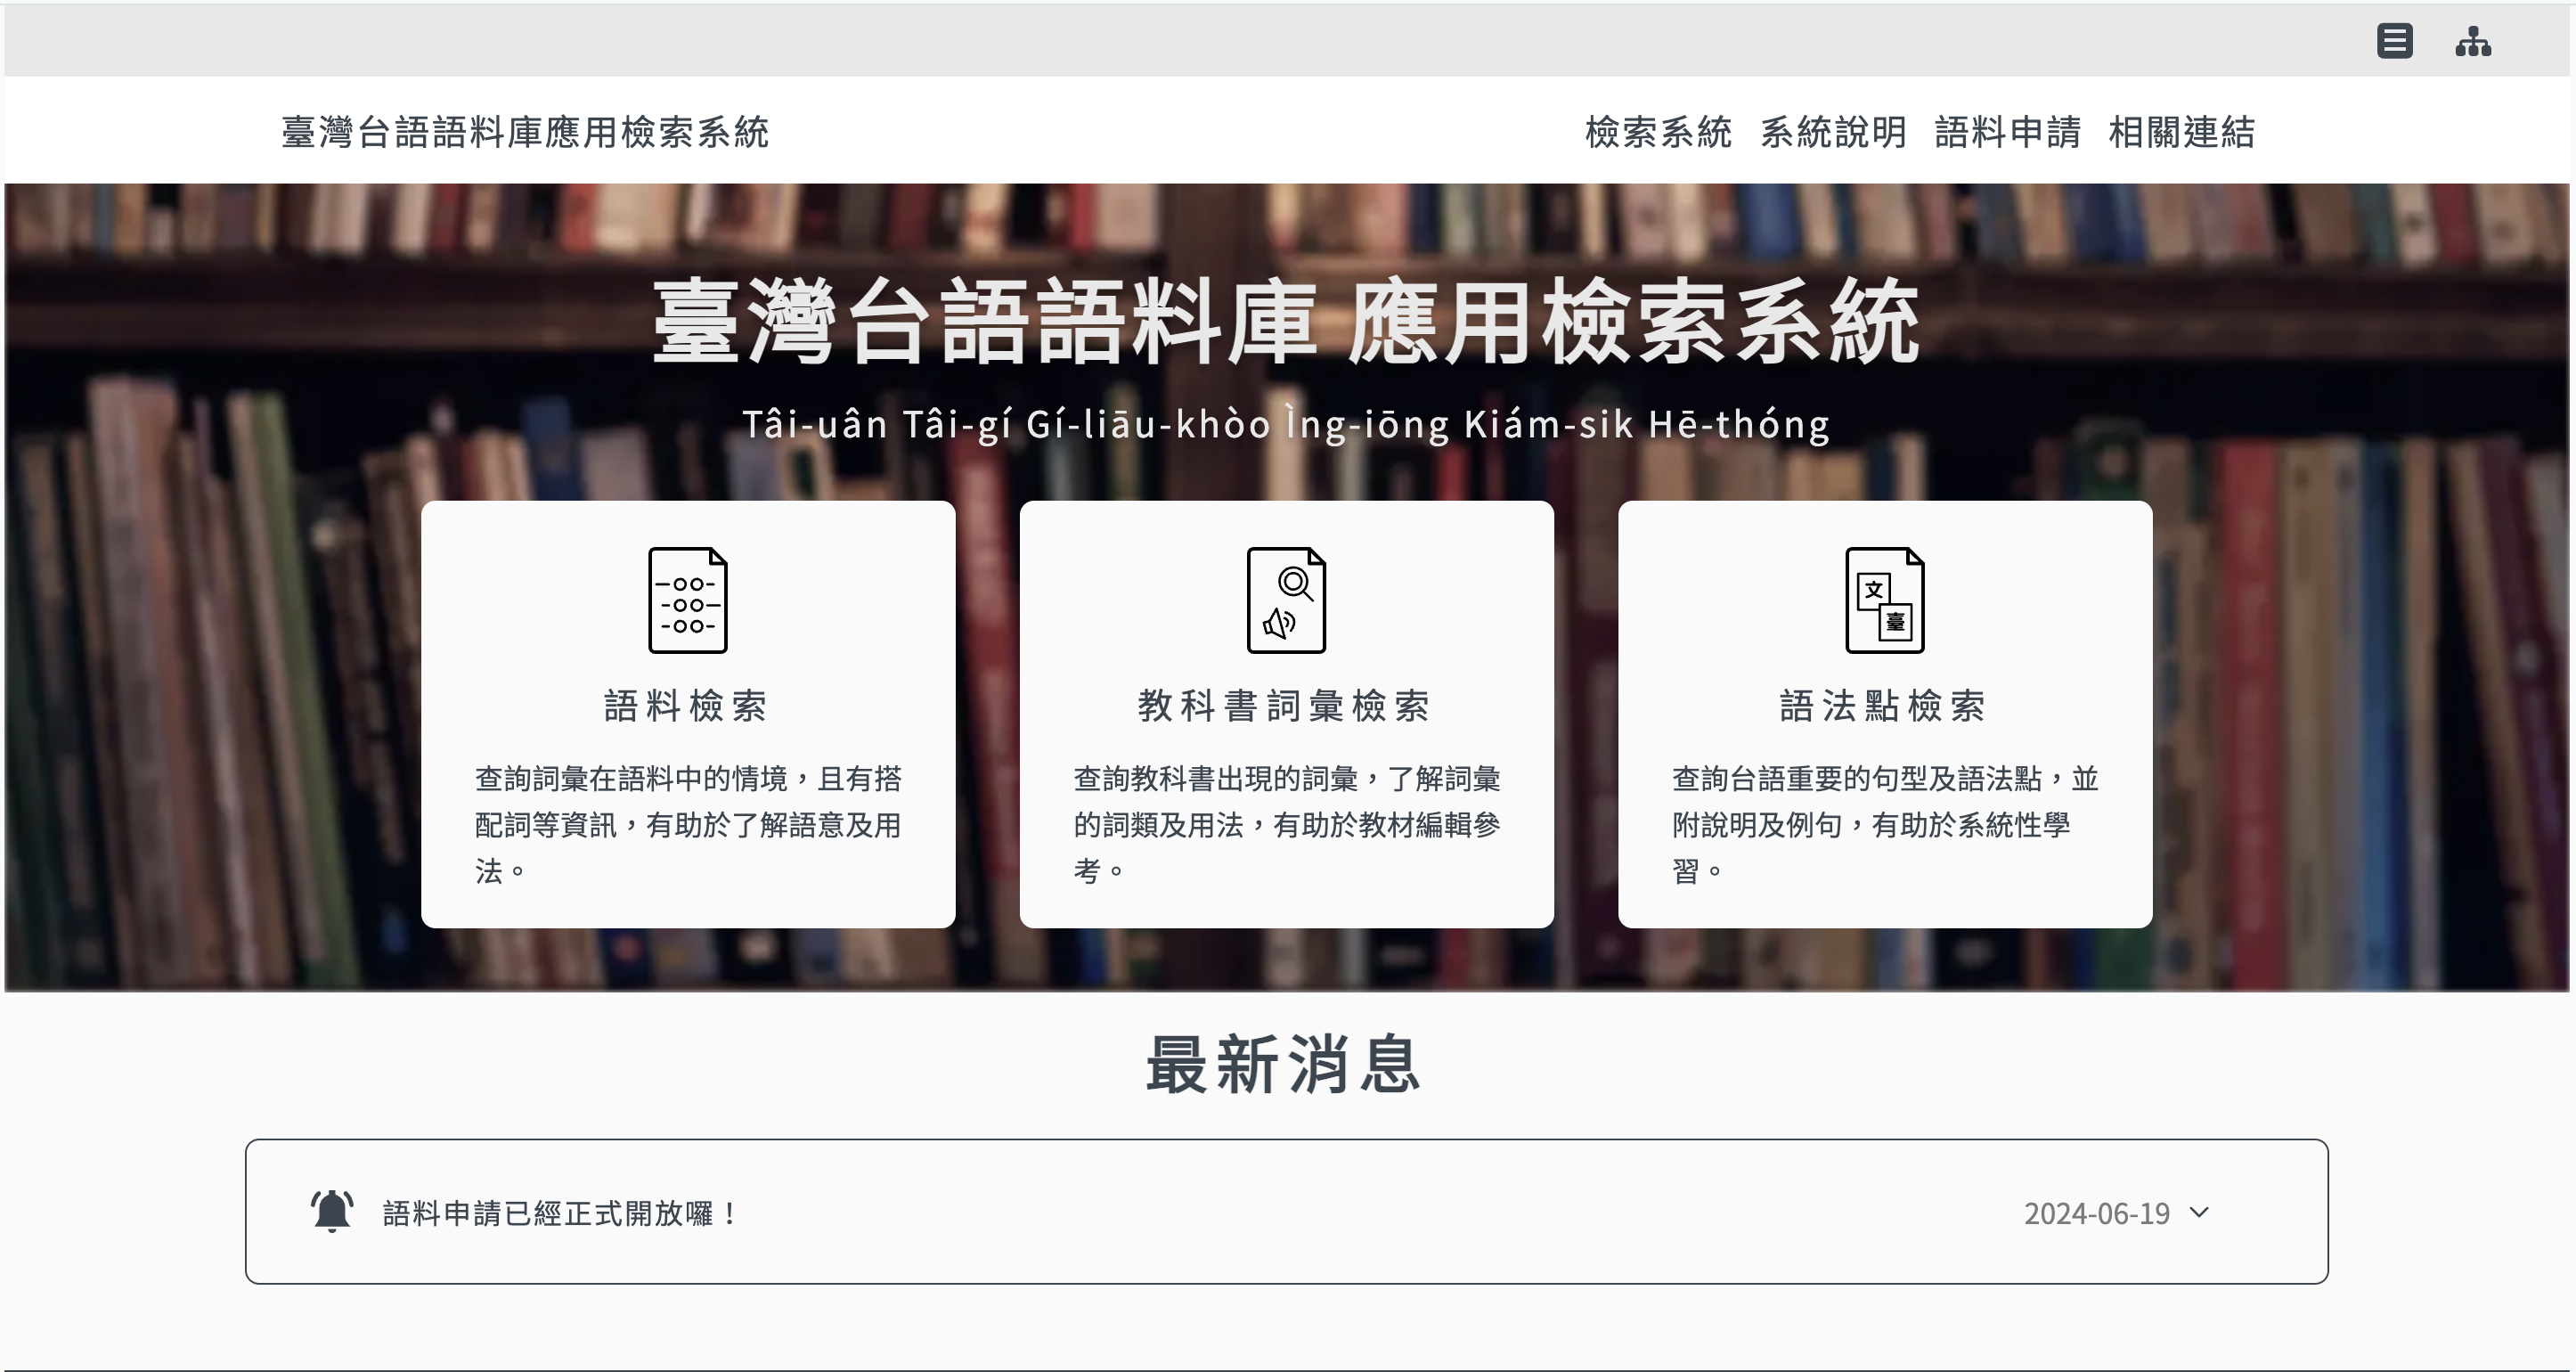
国家レベルの言語ビッグデータ・エンジニアリング:台湾語の自然言語処理(NLP)とコーパス検索システムの開発
5xRuby(五倍紅寶石)は、コーパスのインポート、自動分かち書き、ローマ字表記のマッチング、多次元検索、利用申請とフィードバックといった要件を一つに統合しました。
台湾語の特性上、1 件のコーパスデータの分かち書きを検証するには、句読点、ハイフン、声調記号、空白の処理などを多重にチェックする 10 近くのクレンジングルールを経る必要があります。これにより、最終的に出力される漢字配列と台湾語ローマ字(Tâi-lô)配列が完全に一致することを保証しています。
システムは 8 種類の辞書データベース(華語・台湾語対照辞典、実用台湾語辞典、教科書語彙、文法項目、難解文の対照など)を統合し、「数字による声調検索」機能を実装しました。ユーザーは 1〜8 の数字を入力するだけで、システムが自動的に対応する声調記号に変換して照合します。
さらに、コーパスの利用申請フロー、エラー報告、ご意見フィードバックの仕組みなど、充実したユーザーサービスも整備し、研究者や教育関係者がこれらの貴重な言語データを手軽に利用できるようにしています。
主な強み
全工程のシステム統合:コーパスのインポート、自動分かち書き、ローマ字表記のマッチング、多次元検索、利用申請とフィードバックの仕組みまでを一貫してつなぎ、ワンストップの国家レベル言語データベース・プラットフォームを構築しました。
独自の分かち書き・ローマ字マッチング技術:台湾語の複雑な特性を克服し、長文を入力すると自動的に単語へ分割。同時に 10 のクレンジングルールを実行して句読点、ハイフン、声調記号、空白を正確に処理し、漢字配列と台湾語ローマ字配列を完全に一致させます。
データベース横断の連携と数値化された声調検索:華語・台湾語対照、実用台湾語、教科書語彙など 8 つの辞書データベースを統合し、「数字による声調検索」機能を開発しました。ユーザーは 1〜8 の数字コードで声調ごとに台湾語コーパスを正確に検索でき、多音字や声調の検索という課題を解決して、学術用途にも実務用途にもスムーズな検索体験を提供します。
高信頼性の大規模データベース基盤:国家レベルの研究機関が保有する膨大なコーパス資産を受け止めるため、高い拡張性と厳格なセキュリティ管理を備えた大規模データベースシステムを構築し、高度なアルゴリズム開発力とデータ処理能力を発揮しました。
研究者向けの充実したサービス:標準化されたコーパス利用申請フロー、エラー報告、フィードバックの仕組みを整備し、研究者や教育関係者が貴重な言語資産を利用する際の効率を大きく高めました。